Искусственный интеллект как помощник в разборе привычек: возможности и ограничения.
Доступно в полной версии:
Знакомая жизнь в новом зеркале
Вечером человек открывает телефон, чтобы посмотреть одно сообщение, а через некоторое время обнаруживает себя среди коротких роликов. Утром он обещает больше гулять, но после рабочего дня вспоминает об этом уже дома. Эти маленькие сцены знакомы многим. Теперь их можно описать искусственному интеллекту и получить аккуратную историю: что повторяется, какие обстоятельства совпадают и где есть место для другой версии событий.
Привлекательность такого разговора понятна. Помощник не устаёт от длинного списка, умеет переформулировать и быстро предлагает названия для смутных наблюдений. Но зеркало может дорисовывать детали. Текст, похожий на понимание человека, иногда оказывается всего лишь убедительной композицией. Именно это различие делает тему интересной: когда технология помогает рассмотреть повседневность, а когда незаметно подменяет её своим рассказом.
Здесь рассматриваются сон как бытовой распорядок, питание как организация обычных дел, движение, внимание, покупки и домашняя среда. Вымышленные персонажи и их дневники нужны для занимательного разбора ситуаций. Они не являются участниками исследований. Все числовые примеры, не относящиеся к явно названной работе, обозначены как вымышленные. Схемы показывают авторские способы рассуждения, без приписывания им научной валидации.
Три разных слоя
Факт — проверяемая запись или результат источника. Гипотеза — возможное объяснение, которому могут противоречить новые сведения. Авторская модель — удобный способ разложить историю по полочкам. Эти слои будут встречаться рядом, но их смысл различается. Исследования помогают очертить границы; они не превращают каждую сцену в доказательство. Организационные рамки рисков также не удостоверяют безопасность конкретного сервиса [15], [16].
Что скрывается за словом «привычка»
В бытовой речи привычкой называют почти любое повторение: любимый завтрак, вечернюю прогулку, перечитывание сообщения перед отправкой. Для разбора с ИИ этого широкого слова мало. Одинаково частые действия могут устроиться по-разному: одно каждый раз выбирают сознательно, другое начинается при знакомом сигнале почти без раздумий. Обзор Wood и Rünger связывает привычное повторение с устойчивым контекстом; работа Gardner и соавторов отдельно рассматривает автоматичность в самоотчёте [2], [3].
В вымышленной сцене Лена часто пьёт чай после возвращения домой. Это ещё не позволяет решить, действует ли она автоматически, выбирает напиток ради удовольствия или просто следует общему домашнему распорядку. ИИ способен поставить эти версии рядом. Он не наблюдал момент выбора и не может восстановить его по одной фразе «всегда пью чай».
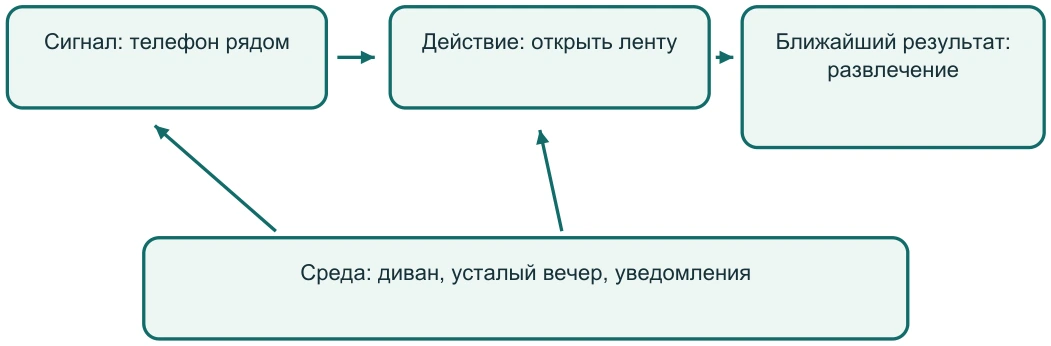
Авторская иллюстрация возможного эпизода. Размеры элементов не кодируют данные.
Удобно различать начало действия, само действие и ближайший заметный результат. Вечерний скроллинг может начинаться из-за уведомления, положения телефона, ожидания ответа или желания развлечься. Тот же результат — несколько минут в ленте — не выдаёт единственной причины. В авторской схеме среда показана рядом с сигналом, чтобы не сводить рассказ к характеру персонажа.
Подпись «слабая воля» ничего не добавляет к описанию эпизода. Она скорее закрывает дальнейшее любопытство. Более содержательная формулировка звучит так: «телефон лежал на диване, после ужина появилась пауза, открылось приложение». Эта версия остаётся скромной, зато её части можно соотнести с исходной записью. В этом и состоит полезная роль помощника на первом шаге: уточнять, что именно произошло, до обсуждения того, почему это произошло.
Что делает языковой помощник
Под словом «ИИ» скрываются разные технологии. Простой бот ведёт по заранее заданным веткам, классификатор относит запись к категории, а языковая модель создаёт продолжение текста в ответ на запрос. В приложении они могут работать вместе. Поэтому наличие разговорного окна ещё не описывает ни устройство системы, ни её проверенные возможности.
Генеративный ответ строится на закономерностях текста и входном контексте. Такая система может составить хорошую таблицу или удачно сформулировать уточняющий вопрос. Одновременно она может уверенно добавить несуществующее событие или ссылку; NIST рассматривает подобные конфабуляции как отдельный риск [15]. Гладкость фразы — свойство ответа, а соответствие дневнику — свойство его отношения к данным. Эти свойства приходится оценивать раздельно.
Один запрос, несколько операций
Фраза «разбери мои привычки» включает слишком много возможных задач. Помощник может начать с резюме, искать закономерности, оценивать поведение, давать советы или строить прогноз. Человек иногда ожидает лишь упорядоченного списка, а получает целую историю о собственной мотивации. Расхождение возникает ещё до первой фактической ошибки: стороны подразумевали разные виды работы.
В авторском примере более узкое описание выглядит так: «Сгруппируй пять записей по времени суток. Сохрани неизвестное неизвестным. Не объясняй причины». Проверяемость здесь выше, потому что результат можно сопоставить с небольшим исходным набором. Следующий запрос может отдельно попросить альтернативные объяснения. Их статус при этом остаётся гипотетическим.
Помощник полезен как обработчик ограниченного материала. Чем шире вывод — от списка событий к внутренним мотивам, будущему поведению или решениям о здоровье, — тем больше предпосылок остаётся непроверенными. Обзор Ji и соавторов показывает, что неподтверждённое содержание обсуждается в разных задачах генерации текста [19]. Ни одна красивая форма диалога сама по себе не снимает эту границу.
Где помощь наиболее понятна
Бытовой дневник редко выглядит как аккуратная база. В нём соседствуют «поздно лёг», «день был тяжёлый», «телефон до ночи» и «вечером не до прогулки». ИИ может привести фразы к единому словарю, отделить время от события, найти повторяющиеся выражения и подготовить несколько вариантов резюме. Польза таких операций заметна в самом результате: записи становятся удобнее для просмотра.
Модель Li, Dey и Forlizzi различает подготовку, сбор, объединение, осмысление и действие. Она получена из опросов и интервью, а не из испытания нынешних помощников [5]. Для нашей темы её ценность в том, что красивый анализ начинается задолго до ответа ИИ. Если вопрос выбран неясно, а записи противоречат друг другу, последующие шаги наследуют эти затруднения.
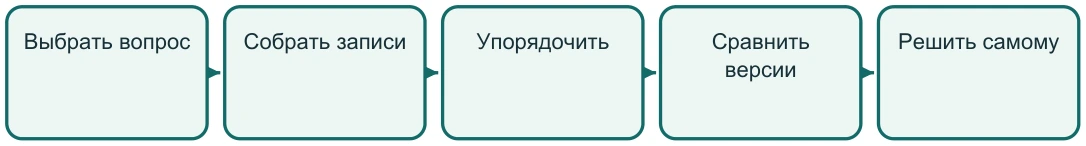
Возврат к исходным записям возможен на любом шаге.
В авторской версии этого маршрута помощник особенно удобен в середине: упорядочить и сравнить. Выбор интересующего вопроса и окончательное решение принадлежат человеку. Это не жёсткий закон, а способ удержать обзор над рассказом. Можно возвращаться к исходным строкам, менять категории и отказываться от лишнего анализа.
Представим список вечерних дел: переписка, покупки, сериал, уборка. Автоматическое объединение всего этого в «экранное время» сэкономит место, но уничтожит различия между работой, бытовой задачей и отдыхом. Хорошая группировка должна отвечать текущему вопросу. Если вопрос касается вечернего развлечения, покупки могут быть отдельной категорией. Если вопрос касается расположения телефона, важнее место и момент начала.
Здесь возможности ИИ вполне конкретны. Он помогает увидеть несколько способов представления одного материала. Однако удачный способ представления ещё не сообщает, какое действие принесёт человеку желаемый результат. Для этого необходимы сведения за пределами форматирования дневника.
Чего нет в загруженных записях
Когда помощник видит дневник, он видит описание жизни, а не саму жизнь. Из списка прогулок нельзя узнать, насколько безопасен маршрут. Из упоминания позднего вечера нельзя восстановить семейные обязанности. Из фотографии стола нельзя надёжно вывести отношения человека с едой. ИИ может догадаться о таких обстоятельствах, но догадка не пополняет исходные данные.
В вымышленной истории Артём записывает, что трижды отменил прогулку. Помощник объясняет это отсутствием мотивации. Вне дневника остаётся ремонт лифта, дождь и ожидание доставки. Эти детали не доказывают, что мотивация совсем не играет роли. Они показывают, насколько быстро одна версия занимает место многих возможных объяснений, если система не обозначает пробелы.
Три вида неизвестного
Первый вид — событие могло произойти, но не записано. Второй — событие описано расплывчато: «занят весь вечер» без времени и границ. Третий — нужное обстоятельство вообще не относится к выбранному дневнику. Например, список уведомлений ничего не говорит о том, почему сообщение было важно. Смешение этих видов неизвестного создаёт иллюзию полной картины.
Исследования личного наблюдения отмечают разрывы между сбором, объединением и осмыслением данных [5], [7]. В наших сценах это означает, что качество ответа зависит не только от модели. Даже очень аккуратная обработка не исправит сведения, которых нет. Иногда лучший ответ состоит из короткого резюме и списка того, что остаётся неизвестным.
Содержательный помощник должен уметь остановиться на границе видимого. Формулировка «в дневнике нет данных о погоде» лучше выдуманного рассказа о погоде. Но и длинный список вопросов не всегда полезен: можно потратить вечер на уточнения, которые не имеют отношения к интересующему эпизоду. Авторский критерий прост — дополнительная деталь нужна лишь тогда, когда способна изменить конкретный вывод.
Источники и Список литературы
- [1] Lally P., van Jaarsveld C., Potts H., Wardle J. (2010). How are habits formed: Modelling habit formation in the real world Изучено: аннотация, результаты моделирования автоматичности, описание выборки и таблица 2. Граница доступа: доступны прочитанные разделы PDF; полный текст целиком не заявляется прочитанным. Что даёт теме: 96 добровольцев, 82 с достаточными данными; модель с хорошим соответствием у 39. Медиана достижения 95% асимптоты в этой группе — 66 дней. Ограничение: самоотчёт, выбранные действия, модельные сроки 18-254 дня; это не норматив для любого человека и не проверка ИИ. https://repositorio.ispa.pt/bitstream/10400.12/3364/1/IJSP_998-1009.pdf
- [2] Wood W., Rünger D. (2016). Psychology of Habit Изучено: аннотация обзора на странице издателя. Граница доступа: полный обзор не изучен. Что даёт теме: привычное повторение связано с повторяющимся контекстом; намерение и автоматичность не тождественны. Ограничение: обзор механизмов, без испытания современных чатботов; детали отдельных исследований из него не переносились. https://www.annualreviews.org/content/journals/10.1146/annurev-psych-122414-033417
- [3] Gardner B., Abraham C., Lally P., de Bruijn G.-J. (2012). Towards parsimony in habit measurement Изучено: аннотация с методом и результатами, фрагмент отбора четырёх пунктов SRBAI. Граница доступа: изучен индексированный текст; последующие обращения к PMC ограничены проверкой браузера. Что даёт теме: частота поведения и ощущение автоматичности требуют различения; проверялся четырёхпунктовый индекс самоотчёта. Ограничение: вторичные анализы и четыре набора данных определённых видов поведения; не объективный датчик и не диагноз. https://pmc.ncbi.nlm.nih.gov/articles/PMC3552971/
- [4] Michie S., van Stralen M., West R. (2011). The behaviour change wheel Изучено: аннотация: фон, метод, результаты, выводы. Граница доступа: изучен индексированный текст аннотации; полный текст не изучен. Что даёт теме: модель COM-B различает возможности человека, условия среды и мотивацию; авторы рассмотрели 19 рамок. Ограничение: концептуальная разработка и проверка классификации в двух областях; не доказательство эффективности любого бытового совета. https://pmc.ncbi.nlm.nih.gov/articles/PMC3096582/
- [5] Li I., Dey A., Forlizzi J. (2010). A Stage-Based Model of Personal Informatics Systems Изучено: аннотация, определение, Method, Participants, начало Results. Граница доступа: изучены указанные разделы авторского PDF; вся статья целиком не заявляется прочитанной. Что даёт теме: пять стадий работы с личными данными; 68 опрошенных и 11 интервью; барьеры могут переходить к следующим стадиям. Ограничение: технологически опытная выборка, качественная модель; не случайное испытание эффекта ведения дневника. https://www.ianli.com/publications/2010-ianli-chi-stage-based-model.pdf
- [6] Epstein D., Ping A., Fogarty J., Munson S. (2015). A Lived Informatics Model of Personal Informatics Изучено: аннотация, Introduction, Selecting Tools, Tracking and Acting, Lapsing. Граница доступа: прочитаны эти разделы авторского PDF. Что даёт теме: наблюдение вплетено в жизнь; перерывы бывают разными. Опросы трёх доменов и 22 интервью. Ограничение: самоотчёты пользователей; модель не задаёт идеальной частоты наблюдения. https://depstein.net/assets/pubs/depstein_ubi15.pdf
- [7] Choe E. K., Lee N. B., Lee B., Pratt W., Kientz J. (2014). Understanding Quantified-Selfers' Practices in Collecting and Exploring Personal Data Изучено: аннотация, авторство, описание анализа 52 видеозаписей выступлений. Граница доступа: доступен индексированный начальный фрагмент; полный текст не изучен. Что даёт теме: даже опытные любители наблюдения сталкиваются с интеграцией и интерпретацией данных. Ограничение: выступления активных участников Quantified Self; это не представительная выборка всех пользователей. https://terpconnect.umd.edu/~choe/download/CHI-2014-Choe-QuantifiedSelf.pdf
- [8] Epstein D., Caraway M., Johnston C., Ping A., Fogarty J., Munson S. (2016). Beyond Abandonment to Next Steps Изучено: аннотация репозитория: дизайн и основные категории результатов. Граница доступа: изучен индексированный текст; прямое открытие требовало JavaScript, полный текст не изучен. Что даёт теме: 193 опрошенных и 12 интервью; прекращение наблюдения имеет разные причины и последствия. Ограничение: наблюдательные ответы; прекращение использования само по себе не доказывает ни успех, ни неудачу. https://escholarship.org/uc/item/0655n3p4
- [9] Harkin B. и соавторы (2016). Does monitoring goal progress promote goal attainment? Изучено: полная аннотация, авторство и библиографическая запись PubMed. Граница доступа: полный текст метаанализа не изучен. Что даёт теме: 138 рандомизированных исследований, 19 951 участник; средний эффект на достижение целей d=0,40, 95% ДИ 0,32-0,48. Ограничение: разнородные задачи; это результат мониторинга, а не доказательство пользы языковой модели. https://pubmed.ncbi.nlm.nih.gov/26479070/
- [10] Nahum-Shani I. и соавторы (2018). Just-in-Time Adaptive Interventions: Key Components and Design Principles Изучено: аннотация и индексированные фрагменты о меняющемся контексте, вовлечённости и усталости. Граница доступа: полный текст не изучен; прямое открытие PMC ограничено проверкой браузера. Что даёт теме: своевременность поддержки зависит от состояния и восприимчивости человека. Ограничение: рамка проектирования в mHealth; не разрешение чатботу назначать действия или самостоятельно вмешиваться. https://pmc.ncbi.nlm.nih.gov/articles/PMC5364076/
- [11] Klasnja P. и соавторы (2015). Micro-Randomized Trials: An Experimental Design for Developing Just-in-Time Adaptive Interventions Изучено: аннотация о цели дизайна и индексированные методологические фрагменты о проксимальных эффектах. Граница доступа: полный текст не изучен. Что даёт теме: причинный эффект отдельного компонента требует соответствующего дизайна, а не одной линии дневника. Ограничение: методологическая статья; не готовый результат об эффективности уведомлений для каждого человека. https://pmc.ncbi.nlm.nih.gov/articles/PMC4732571/
- [12] Singh B., Olds T., Brinsley J. и соавторы (2023). Systematic review and meta-analysis of the effectiveness of chatbots on lifestyle behaviours Изучено: Abstract, Results: screening и meta-analyses, Discussion, описание критериев и поиска. Граница доступа: открытый основной текст в прочитанных разделах; приложения отдельно не изучены. Что даёт теме: 19 испытаний, 3567 участников, 14 работ с низкой оценкой качества. Смешанный анализ ежедневных шагов g=0,28; RCT-подгруппа g=0,18 с p=0,06. Ограничение: поиск до сентября 2022 года; разные боты, вмешательства и дизайны; нельзя переносить результат на любой современный диалог. https://www.nature.com/articles/s41746-023-00856-1
- [13] Li Y., Liang S., Zhu B. и соавторы (2023). Feasibility and effectiveness of AI-driven conversational agents: A systematic review of randomized controlled trials Изучено: полная индексированная аннотация: дизайн, поиск, методы, результаты и выводы. Граница доступа: полный текст издателя не изучен. Что даёт теме: 21 RCT; результаты по разным исходам непоследовательны, риск смещения различался. Приемлемость и завершение участия не равны эффективности. Ограничение: клинические контексты и поиск до мая 2022 года; использован для границ переноса, без лечебных рекомендаций. https://pubmed.ncbi.nlm.nih.gov/37146391/
- [14] Nahum-Shani I., Murphy S. (2026). Just-in-Time Adaptive Interventions: Where Are We Now and What Is Next? Изучено: аннотация, авторство, год и выходные данные страницы издателя. Граница доступа: полный обзор не изучен. Что даёт теме: даже актуальная рамка признаёт проблемы вовлечения в нужный момент и ограниченную изученность социальных связей. Ограничение: обзор научных задач; не сравнительный тест конкретных бытовых приложений. https://www.annualreviews.org/content/journals/10.1146/annurev-psych-121024-044244
- [15] NIST (2024). AI 600-1: Generative Artificial Intelligence Profile Изучено: Introduction, обзор рисков, разделы 2.2 Confabulation и 2.4 Data Privacy. Граница доступа: изучены указанные разделы открытого PDF. Что даёт теме: уверенный ложный ответ, вымышленные ссылки, утечки и вывод чувствительных сведений входят в риски генеративного ИИ. Ограничение: межотраслевая добровольная рамка; не оценка вероятности ошибки конкретной модели. https://nvlpubs.nist.gov/nistpubs/ai/NIST.AI.600-1.pdf
- [16] NIST (2023). AI 100-1: Artificial Intelligence Risk Management Framework 1.0 Изучено: Executive Summary, раздел 3.1, фрагменты Map и Measure. Граница доступа: прочитаны указанные части PDF; документ целиком не изучен. Что даёт теме: надёжность оценивают в условиях предполагаемого применения; отдельная характеристика не заменяет совместную оценку рисков. Ограничение: организационная рамка, без гарантии безопасности сервиса для личного дневника. https://nvlpubs.nist.gov/nistpubs/ai/NIST.AI.100-1.pdf
- [17] Amershi S., Weld D., Vorvoreanu M. и соавторы (2019). Guidelines for Human-AI Interaction Изучено: аннотация, Table 1: initially, during interaction, when wrong, over time; официальный авторский разбор. Граница доступа: прочитаны перечисленные фрагменты PDF и разбор Microsoft; полный текст не изучен. Что даёт теме: 18 правил; ясные ожидания, исправление, отказ от нежелательной помощи и осторожная адаптация. Ограничение: валидация интерфейсных принципов, включая 49 практиков и 20 продуктов; не испытание изменения привычек. https://www.microsoft.com/en-us/research/wp-content/uploads/2019/01/Guidelines-for-Human-AI-Interaction-camera-ready.pdf
- [18] Buçinca Z., Malaya M., Gajos K. (2021). To Trust or to Think: Cognitive Forcing Functions Can Reduce Overreliance on AI Изучено: полная авторская аннотация. Граница доступа: полный текст не изучен. Что даёт теме: эксперимент с 199 участниками: некоторые формы самостоятельного обдумывания снижали избыточное доверие, но хуже оценивались субъективно. Ограничение: конкретная экспериментальная задача; эффект паузы в бытовом диалоге здесь только авторская аналогия. https://arxiv.org/abs/2102.09692
- [19] Ji Z., Lee N., Frieske R. и соавторы (2022; версия 2024). Survey of Hallucination in Natural Language Generation Изучено: полная аннотация и история версии v7. Граница доступа: полный обзор не изучен. Что даёт теме: проблемы неподтверждённого содержания исследуются в суммаризации, диалоге и других задачах; гладкость текста не заменяет верность данным. Ограничение: обзор, без единого процента ошибок для всех продуктов; детальные классификации не воспроизводятся. https://arxiv.org/abs/2202.03629
- [20] Lin S., Hilton J., Evans O. (2022). TruthfulQA: Measuring How Models Mimic Human Falsehoods Изучено: аннотация, описание замысла бенчмарка на авторской странице. Граница доступа: полная статья не изучена. Что даёт теме: тестирует воспроизведение распространённых ложных представлений; правдоподобие и истинность расходятся. Ограничение: специальный набор вопросов и старые модели; исторические проценты не используются как текущая оценка сервиса. https://aclanthology.org/2022.acl-long.229/
- [21] Maynez J., Narayan S., Bohnet B., McDonald R. (2020). On Faithfulness and Factuality in Abstractive Summarization Изучено: аннотация с методом человеческой оценки и результатами. Граница доступа: полная статья не изучена. Что даёт теме: созданное резюме может добавлять неподтверждённое содержание; текстовые метрики недостаточны для проверки фактов. Ограничение: системы суммаризации и корпуса той работы; не измерение ошибок дневникового помощника. https://aclanthology.org/2020.acl-main.173/
- [22] Sharma M., Tong M., Korbak T. и соавторы (2023; версия 2025). Towards Understanding Sycophancy in Language Models Изучено: полная аннотация, авторство и история версии v4. Граница доступа: полная статья не изучена. Что даёт теме: в пяти исследованных помощниках выявлено подстраивание под взгляды пользователя в четырёх задачах; человеческие предпочтения могут это поощрять. Ограничение: ограниченный набор моделей и задач; актуальные продукты не проверялись автором этого материала. https://arxiv.org/abs/2310.13548
- [23] Turpin M., Michael J., Perez E., Bowman S. (2023). Language Models Don't Always Say What They Think Изучено: полная аннотация версии v2 и библиографическая запись. Граница доступа: полная статья не изучена. Что даёт теме: пошаговое объяснение может рационализировать ответ, не отражая реально повлиявшую подсказку. Ограничение: старые модели и экспериментальные задачи; не универсальная оценка всех объяснений ИИ. https://arxiv.org/abs/2305.04388
- [24] Liu N., Lin K., Hewitt J. и соавторы (2023; TACL 2024). Lost in the Middle: How Language Models Use Long Contexts Изучено: полная аннотация и описание двух задач. Граница доступа: полная статья не изучена. Что даёт теме: положение нужного факта в длинном контексте влияло на результат; объём доступного текста не равен его надёжному учёту. Ограничение: модели и задачи исследованного периода; не гарантированный эффект позиции в каждом нынешнем сервисе. https://arxiv.org/abs/2307.03172
- [25] Carlini N., Tramer F., Wallace E. и соавторы (2021). Extracting Training Data from Large Language Models Изучено: полная аннотация: атакуемая модель, данные и основные выводы. Граница доступа: полная статья не изучена. Что даёт теме: из GPT-2 извлекались запомненные фрагменты публичных данных, в том числе идентификаторы; обработка данных имеет отдельные риски. Ограничение: эксперимент не доказывает, что любой сегодняшний чат публикует переписку или что каждый дневник попадает в модель. https://arxiv.org/abs/2012.07805
- [26] Weidinger L. и соавторы (2021). Ethical and social risks of harm from Language Models Изучено: аннотация: шесть областей риска и назначение обзора. Граница доступа: полный текст не изучен. Что даёт теме: риски охватывают дискриминацию, приватность, ложные сведения и взаимодействие человека с системой. Ограничение: таксономия, без численной частоты рисков; этический принцип не удостоверяет безопасность отдельного продукта. https://arxiv.org/abs/2112.04359
- [27] Shneiderman B. (2020). Human-Centered Artificial Intelligence: Reliable, Safe & Trustworthy Изучено: полная аннотация концептуальной рамки. Граница доступа: полная статья не изучена. Что даёт теме: автоматизация и человеческий контроль могут сочетаться; ответственность не обязательно передавать системе. Ограничение: концептуальный подход; не прямое испытание повседневного ассистента. https://arxiv.org/abs/2002.04087
- [28] Альянс в сфере искусственного интеллекта (2021; размещённая копия 2025). Кодекс этики в сфере искусственного интеллекта Изучено: доступные индексированные положения оглавления: автономия, оценка рисков, ответственность, данные, прозрачность; вводный фрагмент о назначении Кодекса. Граница доступа: основной текст разделов получить не удалось; чтение полного документа не заявляется. Что даёт теме: российская этическая рамка выделяет человеческую автономию, поднадзорность и ответственность. Ограничение: использованы только явно доступные формулировки принципов; не правовое заключение и не сертификат сервиса. https://ethics.a-ai.ru/assets/ethics_files/2025/05/23/%D0%9A%D0%BE%D0%B4%D0%B5%D0%BA%D1%81_%D1%8D%D1%82%D0%B8%D0%BA%D0%B8_20_10_1_yKu2UtZ.pdf
- [29] Fenogenova A., Chervyakov A., Martynov N. и соавторы (2024). MERA: A Comprehensive LLM Evaluation in Russian Изучено: аннотация публикации ACL 2024, авторство; введение и начало раздела Data версии v3. Граница доступа: прочитаны перечисленные части; полный текст целиком не изучен. Что даёт теме: 21 задача, охватывающая 10 навыков; русскоязычные способности требуют отдельного рассмотрения. Ограничение: фиксированные тесты и базовые модели, без доказательства бытовой надёжности или актуального рейтинга. https://aclanthology.org/2024.acl-long.534/
- [30] Taktasheva E., Shavrina T., Fenogenova A. и соавторы (2022). TAPE: Assessing Few-shot Russian Language Understanding Изучено: полная аннотация, авторство, описание задач и устойчивости к искажениям. Граница доступа: полная статья не изучена. Что даёт теме: шесть задач русскоязычного понимания; орфографические и другие изменения входа проверяют устойчивость. Ограничение: условия zero/few-shot и исследованные модели; не текущая проверка интерфейса конкретного бота. https://aclanthology.org/2022.findings-emnlp.183/
- [31] Банк России (страница обновлена в 2026). Искусственный интеллект на финансовом рынке Изучено: направления использования ИИ и ответы о рисках, ответственности, переключении на сотрудника. Граница доступа: изучен основной текст этих частей официальной страницы; связанный доклад полностью не изучен. Что даёт теме: показывает российский подход к контролю ИИ и возможность человеческого пересмотра в финансовом секторе. Ограничение: отраслевой материал; его правила нельзя автоматически приписывать любому бытовому чатботу. https://www.cbr.ru/fintech/primenenie-iskusstvennogo-intellekta-na-finansovom-rynke/